aa-opencode: modelos de OpenCode con benchmarks y precio en una tabla
Publicado el 21 de October de 2026 en Herramientas
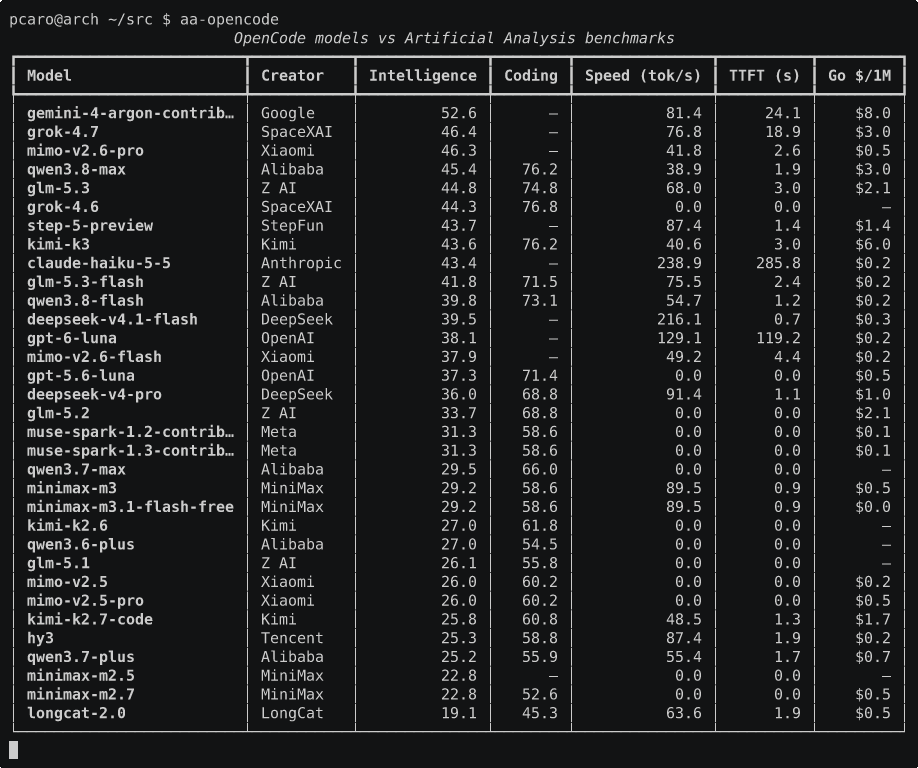
Uso OpenCode como uno de los providers de modelos en pi, y ahí está el problema: la lista de modelos disponibles es larga y no dice nada. Tienes nombres, sí. Lo que no tienes es qué tal razona cada uno, a qué velocidad responde ni cuánto cuesta cada millón de tokens. Elegir a ojo es tirar una moneda.
Artificial Analysis publica justo eso: índices independientes de inteligencia, código y matemáticas, además de velocidad de salida, tiempo hasta el primer token y precio. Pero tiene su propio catálogo y sus propios nombres, así que cruzarlo a mano con los modelos de OpenCode es un rato de trabajo cada vez que quieres mirar.
Así que escribí aa-opencode: coge la lista de modelos de OpenCode, la cruza con la API de Artificial Analysis y saca una tabla. Nada más. Son unas 430 líneas de Python con httpx y rich.
Instalación
uv tool install git+https://github.com/pcaro/aa-opencode
Necesita una API key de Artificial Analysis, que es gratuita: te creas cuenta, generas la key y la dejas en el entorno.
export ARTIFICIAL_ANALYSIS_API_KEY="tu-key"
También lee AA_API_KEY, y si quieres pasarla puntualmente está --api-key.
Uso
# Tabla por defecto, ordenada por inteligencia
aa-opencode

# Otros criterios de orden
aa-opencode --sort price
aa-opencode --sort speed
aa-opencode --sort coding

# JSON para encadenarlo con otra cosa
aa-opencode --format json
Por defecto tira del catálogo Go. Para el catálogo Zen:
aa-opencode --catalog zen
Lo que sale
En el catálogo Go hay 33 modelos con datos en Artificial Analysis. Lo primero que salta a la vista es que el modelo más inteligente del catálogo no es el que usaría para programar todos los días. gemini-4-argon-contributor va primero con 52.6 de índice y cuesta $8.0 por millón. mimo-v2.6-pro saca 46.3 y cuesta $0.5. Dieciséis veces menos para un 11% menos de índice.
En código la cosa se da la vuelta. mimo-v2.5 saca 60.2 de índice de código a $0.2 el millón, y muse-spark-1.2-contributor 58.6 a $0.1. Son modelos que ni me habría planteado abrir sin ver esos números juntos.
Velocidad: claude-haiku-5-5 va a 238.9 tok/s y deepseek-v4.1-flash a 216.1. Pero mira el TTFT del primero: 285.8 segundos. Eso no es tiempo hasta el primer token, es un artefacto del test (colas, rate limits o lo que fuera ese día). Los TTFT de la API hay que leerlos con pinzas.
Y el precio. El de OpenCode no lo da Artificial Analysis: sale de models.dev, que es la fuente que usa OpenCode para su catálogo. Comparando los dos hay modelos donde OpenCode te los deja bastante más baratos que la referencia pública: mimo-v2.5 un 68% menos, longcat-2.0 un 60% menos, deepseek-v4.1-flash un 50% menos.
En Zen el panorama es otro. Ahí los punteros se van a $20 por millón (claude-fable-5-1, gpt-6-astra), y el ranking de calidad/precio se llena de modelos que en Go ni aparecen.
Cuatro modelos de Go no tienen datos en Artificial Analysis: omen-alpha, hy4-preview, longcat-2.5-preview-free y beam-free. Son previews y gratuitos, así que es lo esperable. En JSON salen con matched: false y en la tabla humana los listas con --show-unmatched.
Cómo empareja los modelos
Los IDs de OpenCode y los slugs de Artificial Analysis casi nunca coinciden, así que el emparejador prueba tres cosas en orden:
Slug exacto. gpt-5.4 contra gpt-5.4. Normalizando antes: minúsculas, puntos a guiones y fuera todo lo que no sea alfanumérico.
Subcadena. Si uno contiene al otro, se queda con el slug más corto, que es el más específico. Aquí es donde caen cosas como gemini-4-argon-contributor → gemini-4-argon.
Conjunto de tokens. Para nombres reordenados, tipo haiku-4-5 contra 4-5-haiku.
Es heurística pura, no hay tabla de equivalencias escrita a mano. Funciona bastante bien, pero un modelo mal emparejado da números creíbles y equivocados, que es la peor clase de error. Cuando OpenCode añada modelos nuevos, conviene mirar la fila antes de fiarse.
Lo que no hace
- No dice qué modelo te conviene. Solo pone los números juntos y ordenados.
- No mira disponibilidad: si un modelo está de baja, no se entera.
- No guarda histórico. Cada ejecución es una foto del momento.
- No tiene tabla de equivalencias manual, así que los emparejamientos raros son posibles.
El uso de la API gratuita de Artificial Analysis exige atribución, así que: los benchmarks vienen de Artificial Analysis y el precio de OpenCode, de models.dev.
Fuente original: github.com/pcaro/aa-opencode